Merhaba
Bölüm 1’den Bu Yana: Katmanlar Aynı, Dağılım Farklı
Bölüm 1’de bir yedekleme sistemini beş veri katmanı ve bunları yöneten Control Plane (Yönetim Düzlemi) olarak ele almıştık. Bu bölümde aynı katmanların ortamda nasıl konumlandığını inceliyoruz: yönetim tek merkezde mi toplanıyor, veri hareketi ve depolama lokasyonlara mı dağılıyor, yoksa kapasite ve performans yatay olarak mı büyüyor? Bu üç soru Centralized (Merkezi), Distributed (Dağıtık) ve Scale-out (Yatay Ölçeklenebilir) mimarileri birbirinden ayırır.
Bu mimariler birbirini dışlayan ürün kategorileri değildir. Büyük kurumlarda çoğu zaman birkaçı birlikte kullanılır. Ürün örneklerinde Gartner’ın Mayıs 2026 tarihli Backup and Data Protection Platforms Magic Quadrant (Sihirli Çeyrek) raporunda Leaders (Liderler) çeyreğinde yer alan altı üreticiyi esas alıyoruz: Veeam, Commvault, Cohesity, Rubrik, Druva ve Dell Technologies.
Üç mimarinin karşılaştırması
| Özellik | Centralized (Merkezi) | Distributed (Dağıtık) | Scale-out (Yatay Ölçeklenebilir) |
|---|---|---|---|
| Temel fikir | Tek veya birkaç yönetim sunucusu tüm işleri yönetir | Yönetim merkezde kalır, veri hareketi ve depolama lokasyonlara dağılır | Kapasite ve performans node ekleyerek büyür |
| Control Plane (Yönetim düzlemi) konumu | Merkezde | Merkezde (global) | Cluster’ın içinde veya merkezde |
| Data Plane (Veri düzlemi) konumu | Genellikle tek veri merkezinde | Her lokasyonda yerel Data Mover ve Repository | Cluster node’ları arasında dağılmış |
| Büyüme yöntemi | Mevcut depoyu büyütmek (scale-up) | Yeni lokasyon veya yerel bileşen eklemek | Yeni node eklemek (scale-out) |
| En güçlü yön | Basit kurulum, tek merkezden yönetim | Hızlı yerel restore, WAN (Wide Area Network, Geniş Alan Ağı) yükünün azalması | Büyük veri hacmi, doğrusal büyüme |
| Tipik zayıflık | Katalog ve repository bağımlılığı | Control Plane erişilemezse yerel restore davranışı ürüne bağlı | Hata alanı tasarımı, node arası ağ, rebalancing (yeniden dengeleme) |
| En uygun senaryo | Küçük ve orta ölçekli tek lokasyon | Çok lokasyonlu altyapı | Hızlı büyüyen büyük veri |
Centralized Backup Architecture (Merkezi Yedekleme Mimarisi)
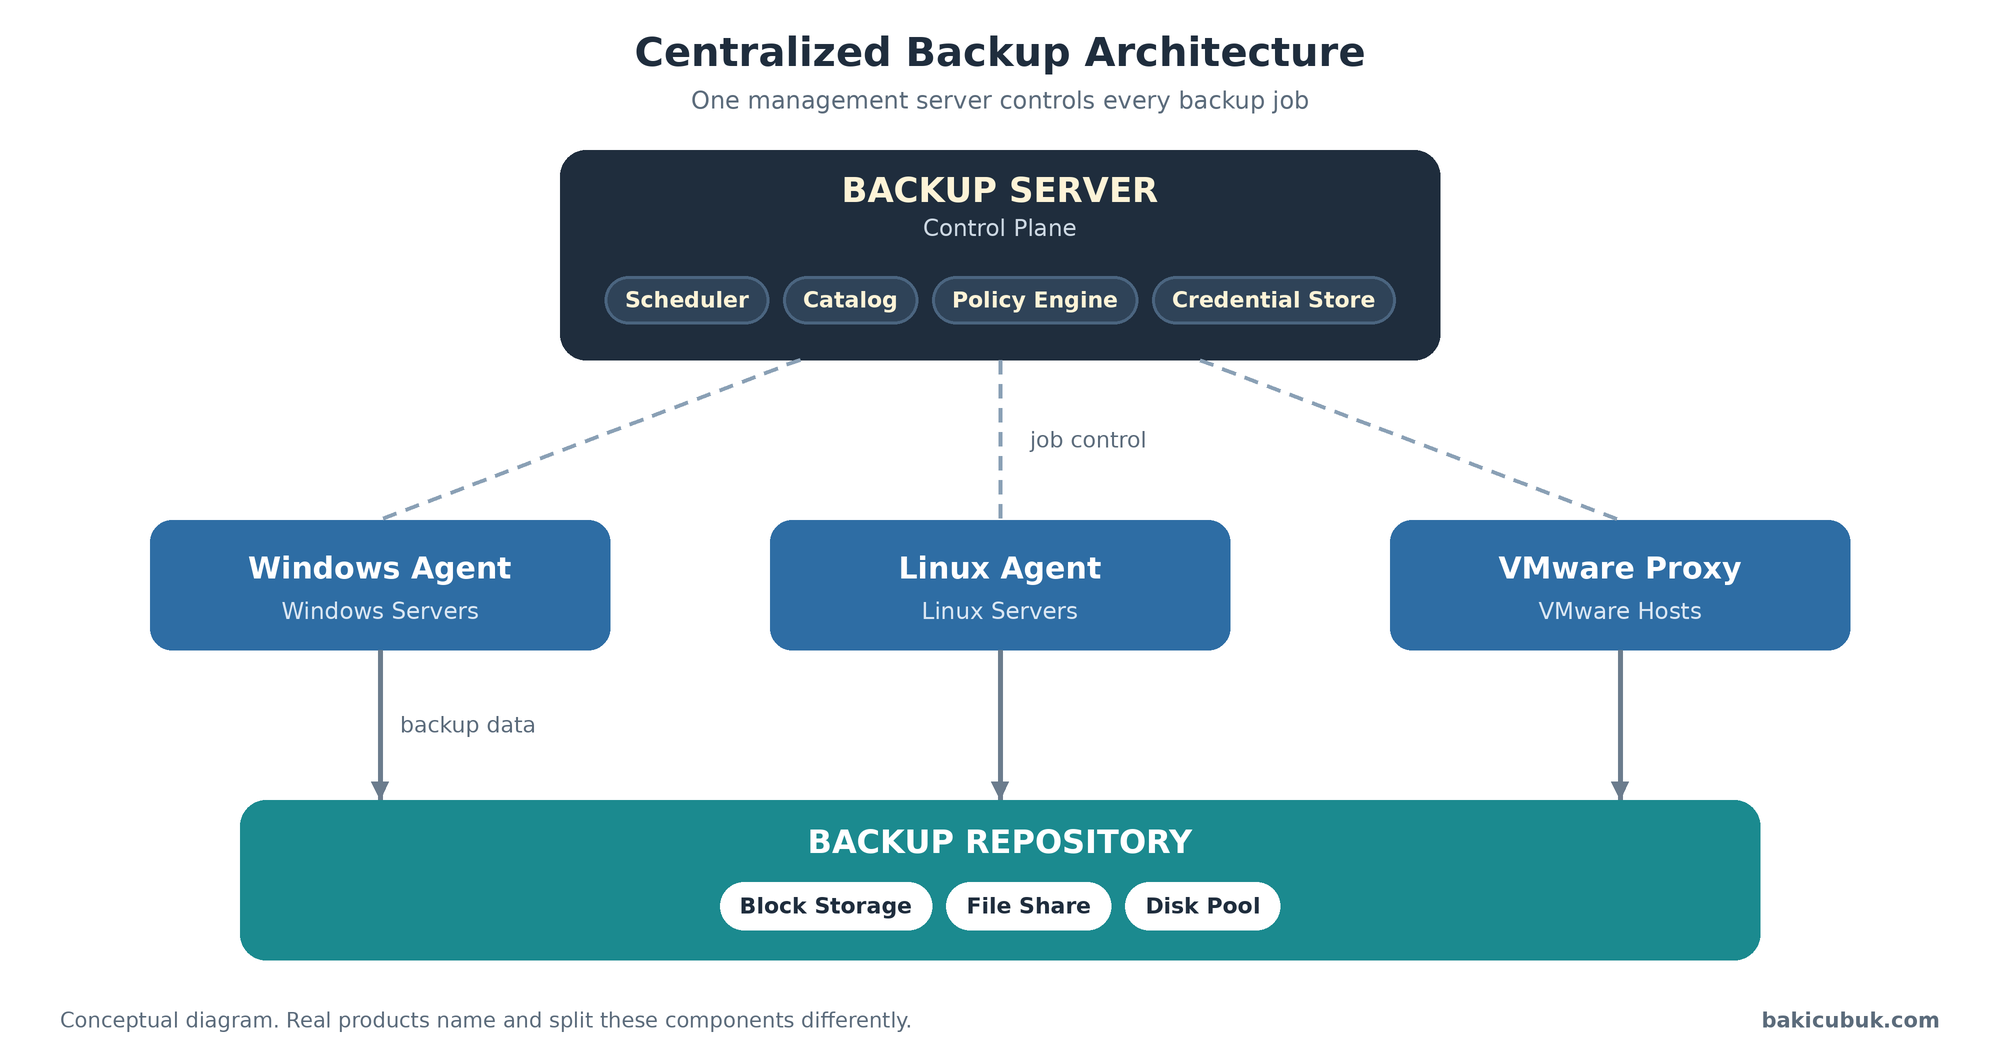
Merkezi mimari, kurumsal yedeklemenin klasik modelidir. Bir veya birkaç yedekleme sunucusu, korunacak tüm sunucuların yedekleme görevlerini yönetir. Aşağıdaki şekil modeli göstermektedir.
 Centralized backup architecture (Merkezi yedekleme mimarisi)
Çalışma Mekanizması
İş akışı şu sırayla ilerler. Scheduler (Zamanlayıcı) işi başlatır. Kaynak sistem, Bölüm 1’de anlattığımız tutarlılık yöntemine göre dondurulur veya snapshot (anlık görüntü) alınır. Veri, Backup Proxy (Yedekleme Vekil Sunucusu) üzerinden repository’ye aktarılır ve bu sırada sıkıştırma, Deduplication (Tekilleştirme) ve şifreleme uygulanabilir. İş tamamlandığında geri yükleme noktasının metadata (üst veri) bilgisi Catalog (Katalog) içine yazılır.
Bu modelin cazibesi sadeliğidir: kurulum ve yönetim nispeten basittir, retention (saklama süresi), raporlama ve job yönetimi tek merkezden yapılır. Küçük ve orta büyüklükteki veri merkezleri için ekonomik olabilir. Bedeli ise merkezi bileşenlere bağımlılıktır.
Merkezi mimarinin yaygın darboğazları ve önlemleri
| Bileşen | Neden darboğaz olur | Belirti | Önlem |
|---|---|---|---|
| Catalog ve yapılandırma veritabanı | Geri yükleme noktası geçmişi büyür, tüm işler aynı veritabanına yazar | İş başlatma gecikmesi, yavaş yönetim konsolu | Hızlı disk üzerinde konumlandırma, düzenli bakım, yapılandırma yedeğini off-site tutma |
| Tek Repository | Tüm işler aynı depoya yazar, depo dolunca birçok iş birlikte etkilenir | Aynı anda başarısız olan çok sayıda iş | Kapasite alarmı, iş gruplarına göre depo ayırma, katmanlama |
| Scheduler ve eşzamanlılık sınırları | Aynı pencerede başlayan işler proxy ve görev yuvası sınırına takılır | Kuyrukta bekleyen işler, aşılan yedekleme penceresi | İş başlangıçlarını dağıtma, proxy sayısını artırma |
| Veri yolu ve ağ | Tüm veri tek sunucu veya tek ağ geçidi üzerinden akar | Sabit hızda doyan ağ arayüzü | Birden fazla Backup Proxy, ayrı yedekleme ağı |
| Kimlik sınırı | Backup Server production AD (Active Directory) ile aynı güven sınırında | Bir saldırının yönetim düzlemine yayılması | Ayrı kimlik alanı, MFA (Multi-Factor Authentication), ayrı yönetim ağı (Bölüm 1) |
| Bakım ve yükseltme penceresi | Tek Control Plane kapalıyken yeni yedek alınamaz | Bakım süresince oluşan RPO (Recovery Point Objective) boşluğu | Bakım penceresini planlama, HA (High Availability, Yüksek Erişilebilirlik) seçeneklerini değerlendirme |
Merkezi Modelin Ürün Karşılıkları
Leaders çeyreğindeki üreticilerden dördü klasik merkezi model terimleriyle konuşur: bir yönetim sunucusu ve ondan ayrık veri hareketi bileşenleri.
| Vendor (Üretici) | Management Server (Yönetim sunucusu) | Data Mover (Veri taşıyıcı) | Not |
|---|---|---|---|
| Veeam | Backup Server | Backup Proxy, Gateway Server | Yapılandırma veritabanı Backup Server tarafında tutulur |
| Commvault | CommServe | MediaAgent | CommServe yönetimi ve veritabanını, MediaAgent veri yolunu taşır |
| Cohesity (NetBackup) | Primary Server | Media Server | NetBackup Catalog Primary Server tarafında tutulur |
| Dell Technologies | PowerProtect Data Manager | Data Manager proxy ve agent bileşenleri | Depo olarak sıklıkla PowerProtect DD (Data Domain) serisi kullanılır |
Distributed Backup Architecture (Dağıtık ve Çok Lokasyonlu Yedekleme)
Büyük kurumlarda tüm verinin tek bir merkezi depoya gönderilmesi, WAN (Wide Area Network, Geniş Alan Ağı) bant genişliği ve kurtarma performansı bakımından verimsiz olabilir. Dağıtık mimaride kontrol merkezi kalabilir, ancak veri aktarımı ve depolama yerel lokasyonlara dağıtılır.
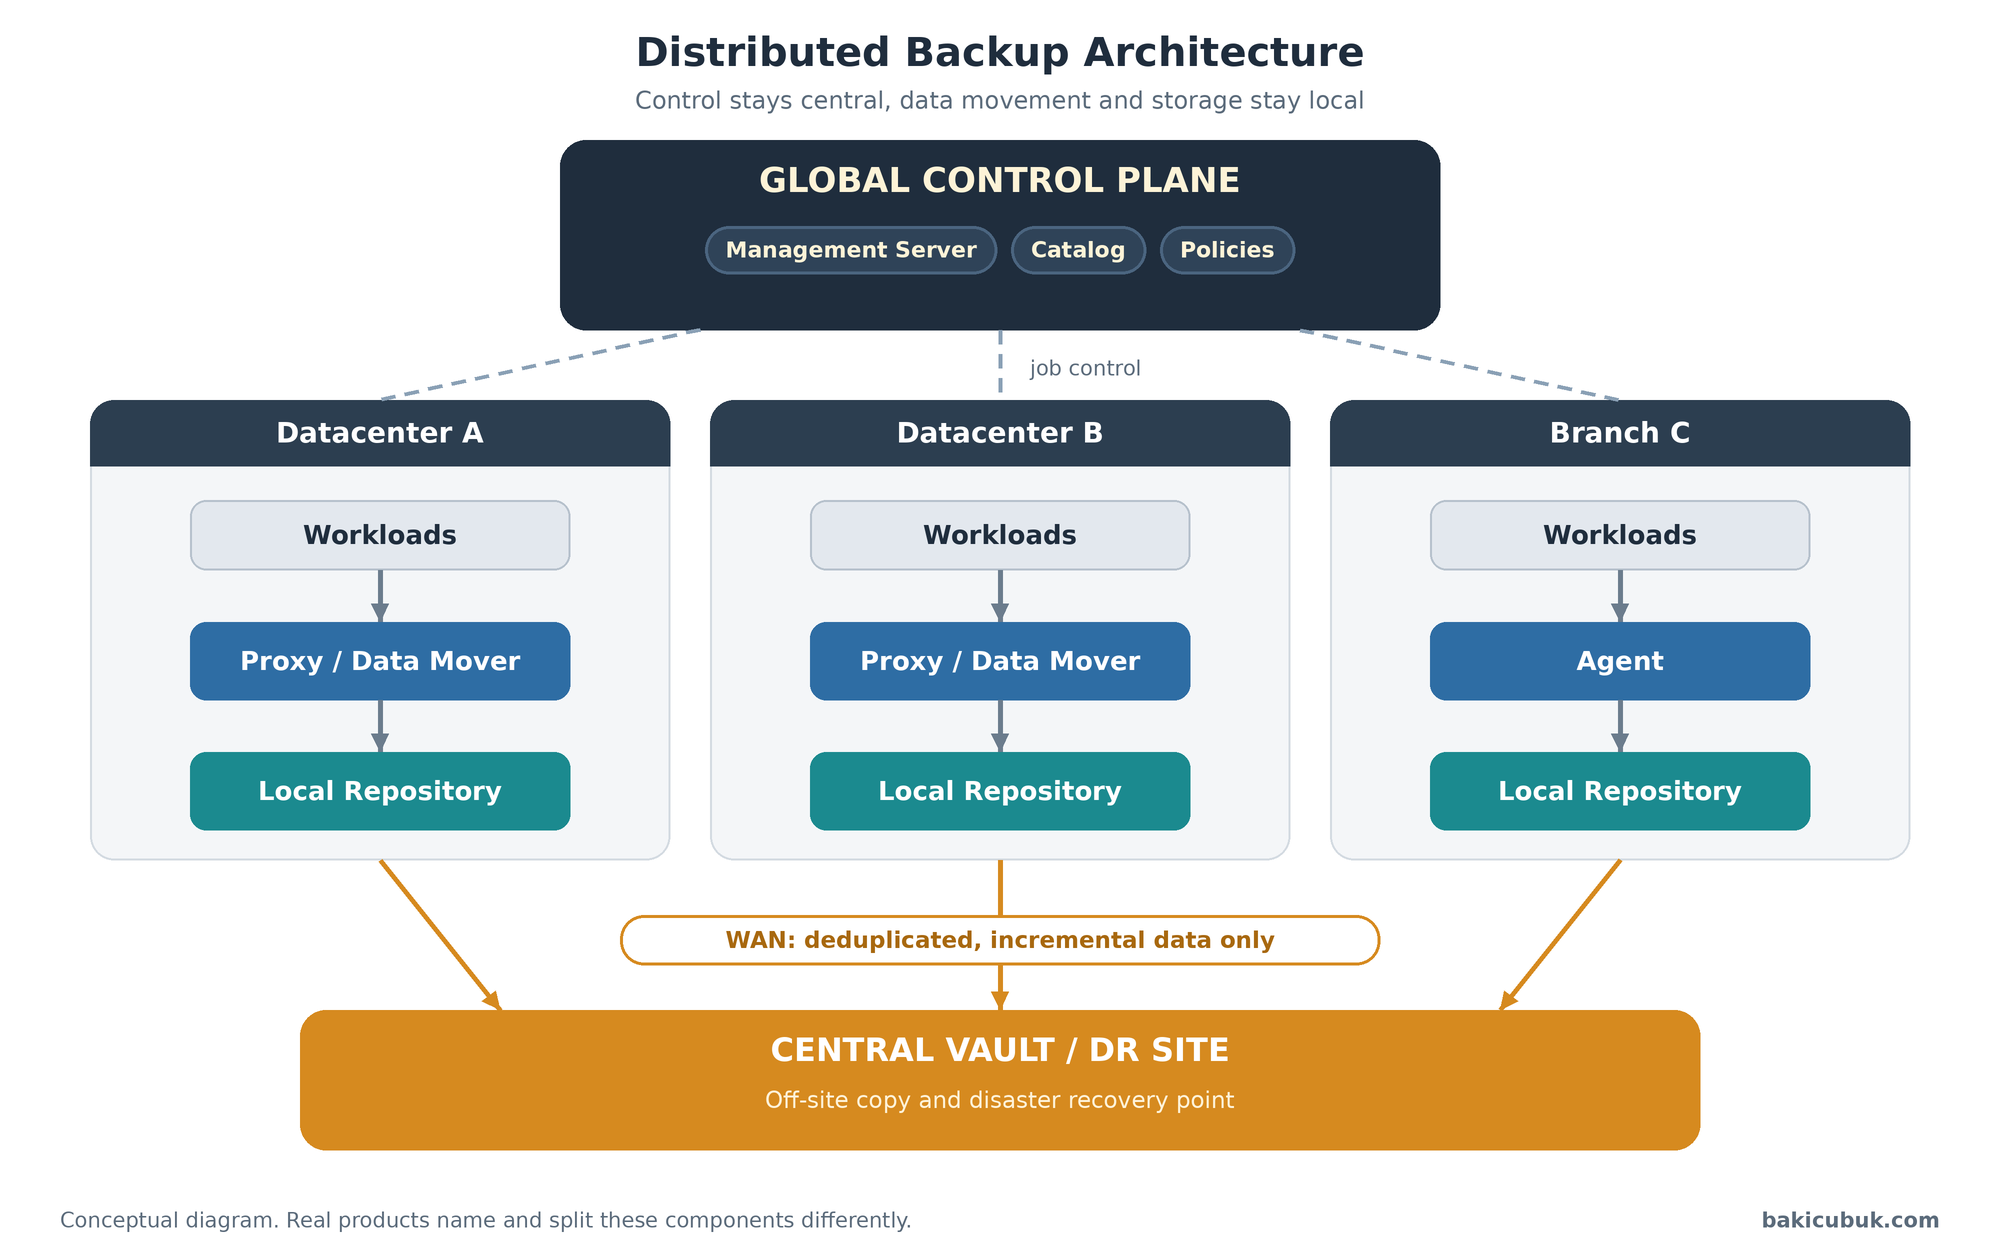 Distributed backup architecture (Dağıtık yedekleme mimarisi)
Teknik Yaklaşım
Her lokasyonda yerel bir Data Mover veya Proxy bulunur. Yedekleme önce yerel Repository’ye yazılır, daha sonra yalnızca yeni veya değişen veri segmentleri uzak merkeze aktarılır. Böylece şubeler yerel olarak hızlı geri dönüş yapabilirken, merkez ofis veya uzak veri merkezi büyük ölçekli bir felakette alternatif kurtarma noktası sağlar. WAN üzerinden taşınan veriyi azaltmak için aşağıdaki teknikler kullanılır.
WAN yükünü azaltma teknikleri
| Teknik | Ne yapar | Kazanç | Dikkat edilecek nokta |
|---|---|---|---|
| Source-side Deduplication (Kaynak tarafı tekilleştirme) | Tekrar eden blokları WAN (Wide Area Network) hattına çıkmadan ayıklar | Aktarılan veri miktarı azalır | Kaynakta CPU (Central Processing Unit, işlemci) ve bellek yükü artar |
| WAN Acceleration (WAN hızlandırma) | Yüksek gecikmeli hatlarda aktarım protokolünü optimize eder | Hat verimi artar | Ürün ve lisans desteği gerekir |
| Delta Transfer (Fark aktarımı) | Yalnızca değişen blokları gönderir | Günlük aktarım hacmi düşer | Değişim takibi bozulursa tam okumaya dönülebilir |
| Bandwidth Throttling (Bant genişliği sınırlama) | Yedekleme trafiğinin kullanacağı hızı sınırlar veya zamanlar | İş trafiği korunur | Pencere kısalır, RPO (Recovery Point Objective) riski doğar |
| Compression (Sıkıştırma) | Veriyi aktarım öncesi küçültür | Hat kullanımı düşer | Zaten sıkıştırılmış veride kazanç sınırlıdır |
| Incremental Forever (Sürekli artımlı) | İlk full yedekten sonra yalnızca artımlı yedek alır | Tekrarlayan full aktarımı ortadan kalkar | Zincir bütünlüğü düzenli doğrulanmalıdır |
WAN Bant Genişliği Nasıl Hesaplanır?
Bir hattın yedekleme trafiğini taşıyıp taşıyamayacağını görmek için basit bir formül yeterlidir: Gereken hız = (Korunan veri x Günlük değişim oranı / Veri azaltma oranı) x 8 / Kopya penceresi. Aşağıdaki tablo bu formülü üç örnek lokasyon için uygulamaktadır. Değerler örnektir, kendi ortamınızda değişim oranını ölçerek hesaplamalısınız.
WAN (Wide Area Network) bant genişliği örnek hesabı
| Lokasyon | Korunan veri (TB) | Günlük değişim | Veri azaltma oranı | Günlük aktarılacak veri (GB) | Kopya penceresi (saat) | Gereken hız (Mbit/s) |
|---|---|---|---|---|---|---|
| Branch Office (Şube) | 2 | %2 | 2:1 | 20,0 | 8 | 5,6 |
| Regional Datacenter (Bölgesel veri merkezi) | 20 | %3 | 2:1 | 300,0 | 8 | 83,3 |
| Main Datacenter (Ana veri merkezi) | 100 | %2 | 3:1 | 666,7 | 10 | 148,1 |
Pratikte hattın yalnızca yedekleme için ayrılmadığını, protokol yükünü ve dalgalanmayı da hesaba katarak bu değerlere en az %30 pay eklemenizi öneririm. İlk tam yedeğin uzak merkeze taşınması ise ayrı bir problemdir. Örneğin bölgesel veri merkezindeki 20 TB verinin ilk kopyası 2:1 azaltmayla yaklaşık 10 TB olur. 200 Mbit/s ayrılmış bir hatta bu yaklaşık 4,6 gün sürer. Bu nedenle ilk kopya için çoğu zaman diskle fiziksel taşıma (offline seeding) veya geçici hat artırımı planlanır.
Yerel Restore Dağıtık Mimarinin Asıl Gerekçesidir
Dağıtık mimaride WAN yükünü azaltmak kadar önemli bir başka gerekçe restore süresidir. Aşağıdaki tablo, 2 TB’lık bir sunucunun üç farklı yoldan geri yüklenmesi için teorik süreleri karşılaştırmaktadır.
2 TB’lık bir sunucunun teorik restore süreleri
| Restore yolu | Hat hızı | Teorik süre | Yorum |
|---|---|---|---|
| Local Repository (Yerel depo) | 10 Gbit/s | 26,7 dakika | Hat ve disk hızı yeterliyse |
| Central Repository (Merkezi depo) üzerinden WAN (Wide Area Network) | 1 Gbit/s | 4,4 saat | Hat başka trafikle paylaşılıyor olabilir |
| Central Repository (Merkezi depo) üzerinden WAN (Wide Area Network) | 100 Mbit/s | 44,4 saat | Küçük şubelerde karşılaşılabilecek bir hat hızı |
Control Plane Erişilemediğinde Ne Olur?
Dağıtık mimarinin kritik sorusu şudur: merkezdeki Control Plane erişilemediğinde yerel kurtarma devam edebiliyor mu? Cevap ürünün mimarisine bağlıdır ve tasarım veya satın alma aşamasında mutlaka test edilmelidir. Aşağıdaki tablo bu testin sorularını listeler.
Dağıtık mimari için Control Plane erişim testi
| Test | Neden önemli | Beklenen sonuç |
|---|---|---|
| Merkez ile lokasyon arasındaki WAN (Wide Area Network) hattı kesildiğinde yerel restore başlatılabiliyor mu? | Felaket anında merkez erişilemeyebilir | Yerel yönetim arayüzü veya yerel katalogla restore mümkün |
| Lokasyon, geri yükleme noktalarını yerelden listeleyebiliyor mu? | Katalog yalnızca merkezdeyse restore noktaları görünmez | Restore noktaları yerelden listelenir |
| Hat kesildiğinde yerel zamanlanmış işler çalışmaya devam ediyor mu? | RPO (Recovery Point Objective) korunmalı | İşler yerelde çalışır, hat gelince senkronize edilir |
| Şifreleme anahtarları lokasyonda kullanılabilir durumda mı? | Şifreli yedekler anahtarsız açılmaz | Anahtar yönetimi ayrı ve erişilebilir |
| Merkez Control Plane tamamen kaybedilirse lokasyon yedekleri yeniden içeri alınabiliyor mu? | Yeniden kurulum senaryosu | Repository yeniden taranarak katalog oluşturulabilir |
Dağıtık Modelin Ürün Karşılıkları
Uzak lokasyondan merkeze kopya mekanizması her üründe farklı adlandırılır. Aşağıdaki tablo, altı üreticinin bu işi hangi terimle yaptığını özetler.
Uzak lokasyon kopyası: üretici terminolojisi
| Vendor (Üretici) | Uzak kopya mekanizması | Not |
|---|---|---|
| Veeam | Backup Copy Job (Yedek kopyalama işi) | İkinci lokasyona veya Veeam Cloud Connect hizmetine kopya |
| Commvault | DASH Copy (Commvault’un tekilleştirilmiş ikincil kopya özelliği) | Yalnızca benzersiz blokları taşır |
| Cohesity (NetBackup) | Auto Image Replication (AIR) | NetBackup ortamları arasında replikasyon ve içe aktarma |
| Dell Technologies | PowerProtect DD (Data Domain) replikasyonu (DD Boost Managed File Replication) | Depo cihazları arasında tekilleştirilmiş replikasyon |
| Rubrik | Replication (Replikasyon) | Hedef ve ilke ayrıntıları için ürün dokümanı esas alınmalıdır |
| Druva | Doğrudan buluta yedekleme (cloud-direct) | Lokasyonda depo gerekmeden SaaS (Software as a Service) platformuna yedekleme, restore hızı internet hattına bağlıdır |
Scale-out Backup Architecture (Yatay Ölçeklenebilir Yedekleme)
Klasik mimarilerde kapasite artışı çoğu zaman mevcut depolama ünitesini büyütmeyi (scale-up) gerektirir. Scale-out mimarisinde ise sisteme yeni node’lar eklenerek kapasite ve bazı tasarımlarda performans artırılır. Şeklin sağ tarafında, bu mimarilerde sıkça karşılaşılan erasure coding (silme kodlaması) mantığı da gösterilmiştir.
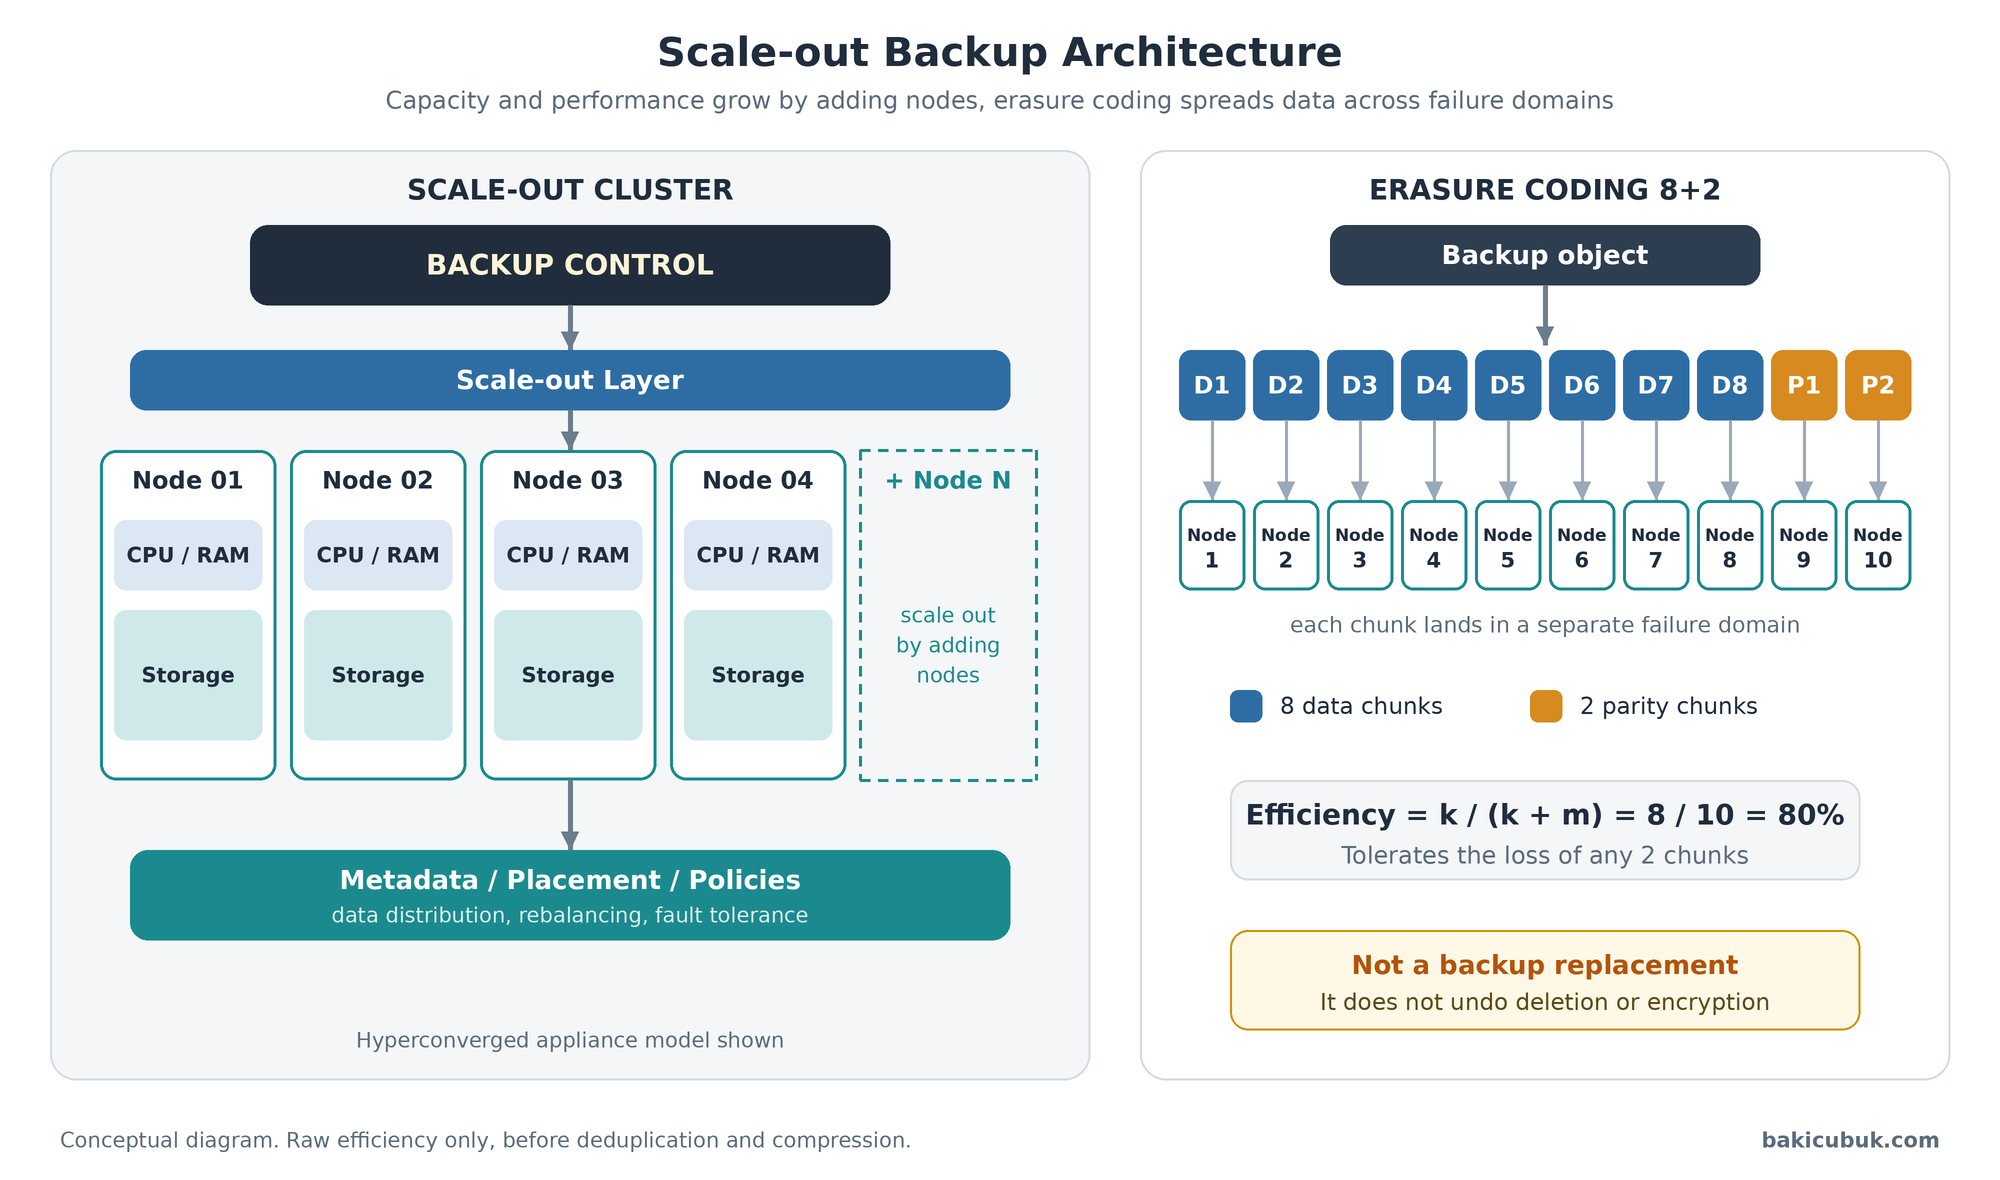 Scale-out backup architecture and erasure coding (Yatay ölçeklenebilir yedekleme mimarisi ve silme kodlaması)
İki Uygulama Modeli
Scale-out kavramı iki farklı şekilde hayata geçer. Scale-out Repository (Yatay Ölçeklenebilir Depo) modelinde birden fazla bağımsız depo tek bir mantıksal havuz olarak yönetilir ve veri yerleşimi politika tabanlıdır. Hyperconverged Backup Appliance (Hiper Yakınsak Yedekleme Cihazı) modelinde ise compute, storage, indeksleme ve bazı durumlarda deduplication aynı node yapısında birleşir; cluster içindeki veri dağıtımı, yeniden dengeleme ve hata toleransı ürün tarafından yönetilir. Her scale-out havuzun dağıtık bir dosya sistemi veya otomatik erasure coding içermediğini unutmamak gerekir.
Scale-out uygulama modelleri
| Model | Çalışma şekli | Veri yerleşimi | Örnek yaklaşım |
|---|---|---|---|
| Scale-out Repository (Yatay ölçeklenebilir depo) | Bağımsız depolar tek mantıksal havuz olarak yönetilir | Politika tabanlı (Veeam’de Data Locality ve Performance politikaları) | Veeam Scale-out Backup Repository |
| Hyperconverged Backup Appliance (Hiper yakınsak yedekleme cihazı) | Compute, storage ve indeksleme aynı node’da birleşir | Cluster yazılımı dağıtır ve yeniden dengeler | Cohesity ve Rubrik cluster yaklaşımları |
| Vendor-managed Cloud Scale (Üretici yönetimli bulut ölçeği) | Ölçekleme müşteriden soyutlanır | Üretici yönetir | Druva, tamamen yönetilen SaaS (Software as a Service) mimarisi |
Kapasite ve Dayanıklılık: Replication ve Erasure Coding
Dağıtık yedekleme depolarında hata toleransı replikasyon veya erasure coding ile sağlanır. Erasure coding, veriyi k adet veri parçasına böler, m adet parity (eşlik) parçası hesaplar ve toplam k+m parçayı farklı hata alanlarına yazar. m parçaya kadar kayıp tolere edilir. Teorik ham depolama verimliliği şu formülle bulunur: Verimlilik = k / (k + m). Örneğin 8+2 şemasında 8 / 10 = 0,8, yani %80’dir.
Replication ve Erasure Coding şemalarının karşılaştırması
| Şema | Tolere edilen kayıp | Gereken minimum hata alanı | Verimlilik | 1 PB ham kapasitede kullanılabilir | Ham kapasite çarpanı | Dikkat |
|---|---|---|---|---|---|---|
| 2-way Replication (2 kopya) | 1 parça | 2 | %50,0 | 500,0 TB | 2,00x | Rebuild hızlı, kapasite maliyeti çok yüksek |
| 3-way Replication (3 kopya) | 2 parça | 3 | %33,3 | 333,3 TB | 3,00x | Yüksek dayanıklılık, kapasite maliyeti en yüksek |
| Erasure Coding 4+2 | 2 parça | 6 | %66,7 | 666,7 TB | 1,50x | Küçük cluster’larda makul verim |
| Erasure Coding 8+2 | 2 parça | 10 | %80,0 | 800,0 TB | 1,25x | Verim yüksek, en az 10 hata alanı gerekir |
| Erasure Coding 10+4 | 4 parça | 14 | %71,4 | 714,3 TB | 1,40x | Daha fazla kayıp tolere eder, parça sayısı artar |
| Erasure Coding 12+4 | 4 parça | 16 | %75,0 | 750,0 TB | 1,33x | Büyük cluster’lar için, rebuild okuma yükü yüksek |
Bu tabloda bir noktayı ayrıca vurgulamak gerekir: şema ancak parçalar bağımsız hata alanlarına dağıtılırsa anlamlıdır. Hata alanı bir disk, bir node, bir rack (kabinet) veya bir veri merkezi olabilir. 8+2 şemasında node düzeyinde tolerans için en az 10 node, rack düzeyinde tolerans için en az 10 rack gerekir. Parçalar 5 rack’e ikişer parça olacak şekilde dağıtılırsa tek rack kaybı tolere edilir, ikinci rack kaybı ise veri kaybına yol açar. Kapasite hesabında ayrıca rebuild (yeniden oluşturma) ve rebalancing için boş alan bırakılmalı, değerler deduplication ve sıkıştırma öncesi ham kapasite olarak okunmalıdır.
Scale-out Tasarımında Sorulacak Sorular
Scale-out tasarım kontrol listesi
| Soru | Neden önemli | Nasıl test edilir |
|---|---|---|
| Hata alanı eşlemesi doğru mu (disk, node, rack)? | Parçalar aynı hata alanına düşerse şema korumasız kalır | Bir node veya rack’i kapatıp verinin erişilebilir kaldığını doğrulama |
| Node arası (east-west) ağ yeterli mi? | Rebuild ve rebalancing bu ağdan geçer | Node çıkarıp rebuild süresini ölçme |
| Metadata ve indeks ölçeği hedef büyüklüğü taşıyor mu? | Büyük cluster’larda katalog ve indeks darboğaz olabilir | Üreticinin desteklenen sınır değerlerini doğrulama |
| Rebuild sırasında restore performansı nasıl etkileniyor? | Arıza anında kurtarma gerekebilir | Rebuild sürerken örnek restore çalıştırma |
| Doluluk eşiği ve kapasite alarmı tanımlı mı? | Dolu cluster’da rebuild için yer kalmaz | Alarm eşiğini ve boş alan politikasını gözden geçirme |
| Yazılım yükseltmesi rolling mi, kesintili mi? | Yedekleme penceresine etki eder | Üretici dokümanı ve test ortamında deneme |
Üç Mimariyi Birlikte Kullanmak
Gerçek kurumsal ortamlar çoğunlukla üçünü birleştirir: şubelerde yerel proxy ve küçük depolar (Distributed), merkez veri merkezinde scale-out bir ana depo (Scale-out) ve hepsini yöneten ortak bir Control Plane (Centralized yönetim). Control Plane’in kendisi, Bölüm 1’de anlattığımız gibi production’dan ayrı bir güven sınırında tutulmalıdır.
Senaryoya göre mimari seçimi
| Senaryo | Önerilen model | Neden | Dikkat |
|---|---|---|---|
| Tek veri merkezi, sınırlı iş yükü | Centralized | Basit kurulum ve yönetim | Off-site kopya ve DR (Disaster Recovery) ayrıca planlanmalı |
| Çok lokasyon, sınırlı WAN (Wide Area Network) | Distributed | Yerel hızlı restore, hat yükü düşük | Control Plane erişim testi yapılmalı |
| Hızlı büyüyen büyük veri hacmi | Scale-out | Node ekleyerek doğrusal büyüme | Hata alanı tasarımı ve node arası ağ |
| Büyük kurum, çok lokasyon ve çekirdek veri merkezi | Hibrit: Distributed + Scale-out + merkezi yönetim | Her katman kendi güçlü yönünü kullanır | Karmaşıklık ve güven sınırı yönetimi |
| Yönetilecek altyapı istenmeyen dağınık ofisler ve SaaS (Software as a Service) iş yükleri | Vendor-managed SaaS (Üretici yönetimli SaaS) | Yedekleme altyapısı işletme yükü yok | Restore hızı internet hattına bağlıdır |
Leaders Üreticilerin Mimari Yaklaşımı
Aşağıdaki tablo altı üreticinin baskın mimari yaklaşımını özetler. Üreticilerin ürün aileleri geniştir ve birden fazla modeli destekleyebilir, bu nedenle tablo kaba bir çerçeve sunar.
Leaders çeyreğindeki üreticilerin baskın mimari yaklaşımı
| Vendor (Üretici) | Baskın yaklaşım | Control Plane (Yönetim düzlemi) | Ölçekleme |
|---|---|---|---|
| Veeam | Software-defined (Yazılım tanımlı) | Backup Server | Proxy ve repository ekleme, Scale-out Backup Repository |
| Commvault | Software-defined, Commvault Cloud platformu | CommServe | MediaAgent ekleme |
| Cohesity | DataProtect scale-out cluster, NetBackup klasik Primary ve Media Server | Helios (DataProtect), Primary Server (NetBackup) | Node ekleme (DataProtect), Media Server ekleme (NetBackup) |
| Rubrik | Cluster tabanlı bütünleşik platform | Rubrik Security Cloud | Node ekleme |
| Druva | Tamamen yönetilen SaaS (Software as a Service) mimarisi | Üretici bulutu | Üretici yönetir |
| Dell Technologies | Yazılım ve depo cihazı birlikteliği | PowerProtect Data Manager | Depo tarafında cihaz ekleme ve replikasyon |
Sonuç ve Sonraki Bölüm
Merkezi, dağıtık ve scale-out mimariler birbirinin alternatifi olmaktan çok, aynı sistemin farklı ölçeklerdeki cevaplarıdır. Merkezi model yönetimi basitleştirir ama bileşenlere bağımlılık yaratır. Dağıtık model WAN yükünü ve restore süresini düşürür ama Control Plane erişilemediğinde davranışın test edilmesini gerektirir. Scale-out model büyümeyi kolaylaştırır ama hata alanı tasarımını zorunlu kılar. Hangisini seçerseniz seçin, kritik soru değişmiyor: felaket anında yedekler bulunabilecek, erişilebilecek ve zamanında geri yüklenebilecek mi?
Serinin 3. bölümünde depolama katmanlarını ele alıyoruz: disk, bant ve bulut. D2D2T (Disk-to-Disk-to-Tape) ve D2D2C (Disk-to-Disk-to-Cloud) modellerini, hızlı restore ile uzun süreli saklama arasındaki dengeyi ve object storage’ın yedekleme depolaması olarak neden önemli hale geldiğini inceleyeceğiz.